Architecture
piighost suit une architecture hexagonale, aussi appelée ports et adaptateurs.
Le coeur ne connaît que des contrats abstraits, les ports. Chaque implémentation
concrète, un détecteur GLiNER2, un backend Redis, un middleware LangChain, est un
adaptateur qui satisfait un port sans que le coeur ne le connaisse. Le pipeline
de dé-identification s'assemble en injectant les adaptateurs voulus derrière les ports
qu'il attend.
Les trois anneaux
Le code se lit en trois anneaux, du plus abstrait au plus concret. Le sens des dépendances est fixé une fois pour toutes. Un anneau extérieur importe un anneau intérieur, et un anneau intérieur n'importe jamais un anneau extérieur.


Trois anneaux et le point de composition. Les dépendances pointent toujours vers le coeur.
- Coeur. Les modèles de données (
Detection,Entity,Span, des dataclasses gelées) et les ports. Aucune dépendance externe, pas de pydantic, pas d'I/O. - Application. L'orchestration du pipeline, qui ne dépend que des ports du coeur.
C'est là que vivent
anonymize,deanonymizeetforget_thread. - Adaptateurs. Les implémentations concrètes des ports, c'est-à-dire les détecteurs, résolveurs, factories, gardes-fous, backends de mémoire, observation, client HTTP, middleware. Chaque adaptateur importe le coeur, jamais le contraire.
- Config. Le point de composition. C'est le seul endroit autorisé à connaître à la fois les ports et les adaptateurs concrets, pour les assembler.
Ports et templates
Un port est un Protocol Python marqué runtime_checkable, dans le base.py de
chaque composant. Le typage y est structurel. Un objet satisfait le port dès qu'il
en a les méthodes, sans en hériter. Le pipeline dépend du port, jamais d'une classe
concrète.
@runtime_checkable
class AnyDetector(Protocol):
    async def detect(self, text: str) -> list[Detection]: ...
Quand plusieurs adaptateurs d'un même port partagent un squelette, ce squelette vit
dans une classe Base*, une classe abstraite qui applique le patron de méthode
(Template Method). Le squelette est écrit une fois dans la classe de base, et chaque
sous-classe ne fournit que le pas qui varie.
class BaseEntityLinker(ABC):
    def link(self, detections: list[Detection]) -> list[Entity]:
        # squelette commun : grouper par clé
        ...

    @abstractmethod
    def _key(self, detection: Detection) -> Hashable:
        # seul pas variable, défini par la sous-classe
        ...
Cinq ports n'ont pas de template commun à tous leurs adaptateurs, ceux du détecteur, de l'override, des gardes-fous, des backends de mémoire et du chiffrement. Leurs adaptateurs diffèrent par tout leur mécanisme, pas par un seul pas, donc ils n'ont rien de commun à factoriser. C'est l'exception assumée à la règle du template systématique.
Le détecteur est une exception partielle. Les détecteurs à modèle (Gliner2Detector,
SpacyDetector, TransformersDetector, PresidioDetector, BridgeDetector,
LLMDetector) partagent le template BaseNERDetector. Il relit le texte de chaque
détection dans la source, applique le seuil de confiance et traduit les labels.
RegexDetector, ExactMatchDetector, CompositeDetector et ChunkedDetector
implémentent le port directement.
Les étapes du pipeline
BaseAnonymizationPipeline enchaîne les étapes de la détection au texte
dé-identifié. Seul le détecteur est un argument obligatoire du constructeur. Le
linking, la dé-identification et la résolution des chevauchements tournent toujours.
Quand on les omet, ils retombent sur des composants intégrés par défaut. Ces
composants sont un ExactEntityLinker, un Anonymizer doté d'une LabelCounterPlaceholderFactory et
un ConfidenceOverlapResolver. Les étapes override, expand, entity-resolve et guard
se comportent en passe-plat quand elles ne sont pas fournies.


Le pipeline. Les étapes toujours exécutées sont en gras, les étapes optionnelles ont un cadre en pointillé.
La page Conception du pipeline explique pourquoi chaque étape existe et pourquoi elles s'enchaînent dans cet ordre. Voici le rôle et l'adaptateur par défaut de chacune.
| Port | Adaptateurs fournis | Rôle |
|---|---|---|
AnyDetector | Gliner2Detector, Gliner2PiiDetector, SpacyDetector, TransformersDetector, PresidioDetector, BridgeDetector, LLMDetector, RegexDetector, ExactMatchDetector, CompositeDetector, ChunkedDetector | Trouve les données confidentielles (données personnelles, secrets), renvoie des Detection positionnées et typées. |
AnyOverlapResolver | ConfidenceOverlapResolver, MergeOverlapResolver | Arbitre les détections qui se chevauchent, garde la plus confiante ou leur union. |
AnyDetectionExpander | WordBoundaryExpander | Rattrape les occurrences ratées d'une valeur déjà détectée. |
AnyEntityLinker | ExactEntityLinker | Regroupe les détections d'une même valeur en une Entity. |
AnyEntityResolver | MergeEntityResolver, FuzzyEntityResolver, SeparateEntityResolver | Réconcilie les entités qui partagent une détection. |
AnyAnonymizer et AnyPlaceholderFactory | Anonymizer et LabelCounterPlaceholderFactory | Remplace chaque entité par son jeton. |
AnyGuardRail | DetectorGuardRail, Gliner2GuardRail, LLMGuardRail, ModerationGuardRail | Re-vérifie la sortie, lève PIIRemainingError sur donnée confidentielle résiduelle. |
L'override (AnyDetectionOverride, adaptateur DetectionOverride) est un composant
serveur optionnel. Il applique une liste à masquer et une liste à laisser en clair à chaque
jeu de détections, juste après la détection, avant la résolution des spans.
Le composant placeholder et ses tags de préservation
L'anonymiseur délègue la forme du jeton à une placeholder factory
(AnyPlaceholderFactory). Ce qui change entre deux factories, c'est ce que le jeton
préserve de la valeur d'origine.


Les tags de préservation, du jeton qui ne garde rien à celui qui identifie chaque entité. Chaque flèche va d'un tag vers son parent et se lit "est un".
Chaque tag est une sous-classe de str. Un jeton est donc une vraie chaîne qui porte
son niveau de préservation dans son propre type. Ces tags sont des types fantômes,
c'est-à-dire qu'ils n'existent que pour le vérificateur de types. Le middleware exige
un tag qui préserve l'identité (PreservesRecognizableIdentity). Brancher une factory
<<PERSON>> sur le middleware est donc une erreur détectée à la vérification de
types, pas une surprise à l'exécution.
Les factories fournies vont du moins au plus informatif. RedactPlaceholderFactory
émet <<REDACT>>, LabelPlaceholderFactory émet
<<PERSON>>, LabelCounterPlaceholderFactory émet
<<PERSON:1>>, LabelHashPlaceholderFactory émet
<<PERSON:a1b2c3d4>>. MaskPlaceholderFactory garde le premier caractère
et masque le reste, si bien que Jonathan devient J*******. Le détail est dans
Fabriques de placeholders.
Le pipeline mono-texte
AnonymizationPipeline traite un texte isolé. Il détecte, applique les étapes
optionnelles présentes, groupe en entités, dé-identifie, puis passe la sortie au
garde-fou. Sa méthode deanonymize reçoit le mapping jeton vers entité produit par
anonymize et restaure les valeurs.
from piighost.components.anonymizer import Anonymizer
from piighost.components.detector import ExactMatchDetector
from piighost.components.linker import ExactEntityLinker
from piighost.components.placeholder import LabelCounterPlaceholderFactory
from piighost.pipeline import AnonymizationPipeline

detector = ExactMatchDetector({"Patrick": "PERSON"})
linker = ExactEntityLinker()
factory = LabelCounterPlaceholderFactory()
anonymizer = Anonymizer(factory)
pipeline = AnonymizationPipeline(
    detector=detector,
    linker=linker,
    anonymizer=anonymizer,
)
result = await pipeline.anonymize("Patrick habite à Paris.")
# result.text   -> "<<PERSON:1>> habite à Paris."
# result.tokens -> {Entity("Patrick"): "<<PERSON:1>>"}
restored = pipeline.deanonymize(result.text, result.tokens)
# restored -> "Patrick habite à Paris."
Le constructeur n'exige que le détecteur. Le linker et l'anonymiseur retombent par
défaut sur ExactEntityLinker et un Anonymizer doté d'une
LabelCounterPlaceholderFactory. Les autres étapes arrivent en argument nommé.
AnonymizationPipeline(
    detector,
    linker,
    anonymizer,
    overlap_resolver=None,  # AnyOverlapResolver, ConfidenceOverlapResolver par défaut
    expander=None,  # AnyDetectionExpander
    entity_resolver=None,  # AnyEntityResolver
    guard=None,  # AnyGuardRail
    override=None,  # AnyDetectionOverride
)
Omettre overlap_resolver, ou passer None, construit un ConfidenceOverlapResolver,
car l'étape de rendu a besoin de spans disjoints. Les étapes expand, entity-resolve,
guard et override restent désactivées quand elles valent None.
Le pipeline conversationnel
ThreadAnonymizationPipeline partage le même socle mais ajoute une mémoire de
conversation (AnyConversationMemory), passée par l'argument nommé memory. Sans cet
argument, le pipeline construit une InMemoryConversationMemory. Un agent
enchaîne des messages, et le même Patrick doit garder le même
<<PERSON:1>> du premier au dernier.
Les jetons sont attribués sur l'union des détections de tous les messages de la conversation, pas sur un message seul. Une valeur revue plus tard retrouve donc son jeton au lieu d'en créer un nouveau. Le rendu, lui, reste par message. Seuls les spans du message courant sont remplacés, parce que les détections de messages différents ne partagent pas le même espace d'offsets.
result = await thread_pipeline.anonymize(text, thread_id="t-42")
restored = await thread_pipeline.deanonymize(reply, thread_id="t-42")
dropped = await thread_pipeline.forget_thread("t-42")- Le
thread_idest obligatoire. Il n'y a pas de conversation partagée par défaut. Deux appelants ne peuvent donc pas tomber dans la même conversation et fuiter leurs données confidentielles. deanonymizereconstruit les jetons de la conversation depuis la mémoire. Il restaure donc n'importe quel texte porteur de ces jetons, y compris une réponse du modèle que le pipeline n'a jamais dé-identifiée.forget_threadefface toute la mémoire d'une conversation et indique ce qui a été supprimé, pour le droit à l'oubli.
La provenance des valeurs
Une valeur dont la première occurrence dans la conversation vient d'un message du modèle
n'est pas une donnée confidentielle de l'utilisateur. La dé-identifier priverait le modèle de sa connaissance du
monde. La mémoire enregistre donc le rôle de la première occurrence de chaque
valeur (MessageRole.USER ou MessageRole.ASSISTANT), et le pipeline laisse en clair
les valeurs introduites par l'assistant.
La mémoire de conversation et le chiffrement
La mémoire est un repository, un port AnyConversationMemory avec trois
adaptateurs.
InMemoryConversationMemorygarde tout dans un dictionnaire du processus, borné par défaut. Simple, suffisant pour un seul worker.RedisConversationMemorypersiste dans Redis, pour un déploiement multi-worker où chaque worker doit voir les conversations des autres.SqlAlchemyConversationMemorypersiste dans une table SQL, pour des conversations longues qui survivent au processus.
Par nature, un backend persistant stocke des données confidentielles, parce qu'il garde
le mapping inverse, qui ramène chaque jeton à sa valeur. Deux composants crypto
optionnels, à fournir ensemble, le protègent sur Redis comme sur SQL. Un AnyHasher
(Sha256Hasher, Argon2Hasher) transforme chaque message en clé déterministe sans
révéler le texte. Un AnyCipher (AesGcmCipher) chiffre les détections au repos, de
sorte qu'une fuite de la base ne révèle ni le message ni les valeurs. Le thread_id reste
en clair, préfixe de clé dans Redis et colonne dans la table SQL, pour qu'une
conversation puisse être énumérée et oubliée.
Le middleware LangChain
PIIAnonymizationMiddleware branche le pipeline conversationnel dans une boucle
d'agent LangChain. Il ne contient aucune logique de dé-identification, il délègue tout
au pipeline. C'est un adaptateur entre le monde LangChain et le coeur.
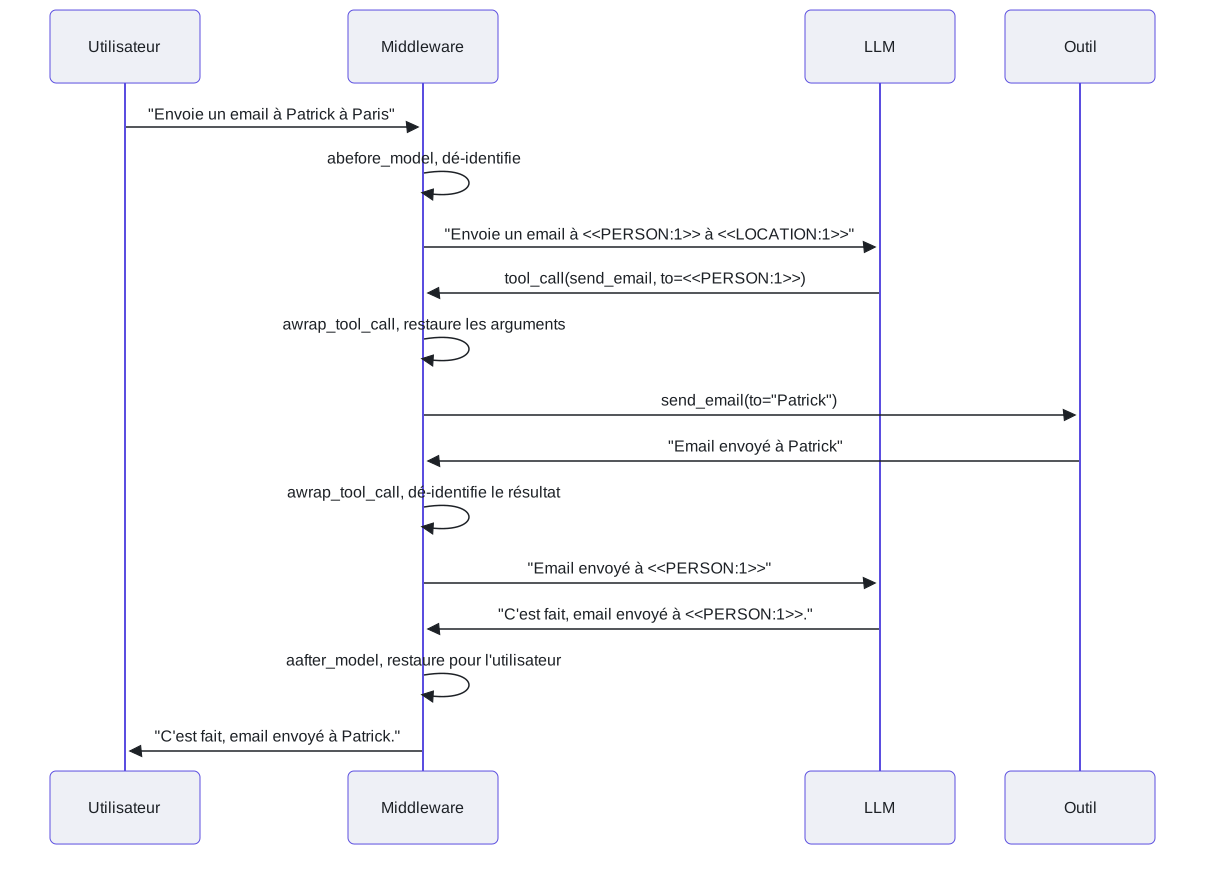
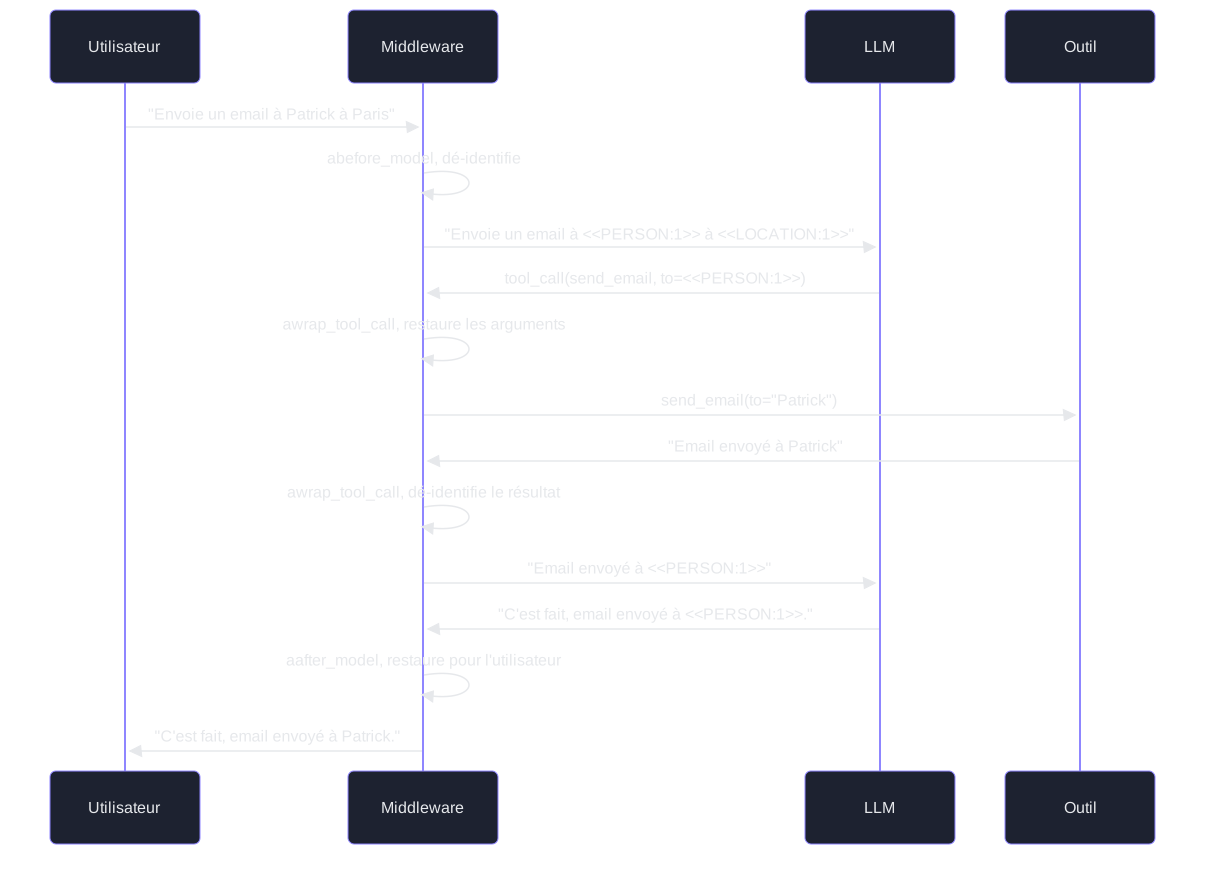
Le middleware intercepte la boucle d'agent en trois points.
abefore_modeldé-identifie les messages avant que le LLM ne les voie.aafter_modelrestaure la sortie du modèle pour l'affichage utilisateur.awrap_tool_calltraite l'appel d'outil selon la stratégie choisie (ToolCallStrategy), en restaurant les arguments pour que l'outil reçoive de vraies données, puis en dé-identifiant sa réponse.
Le type du middleware exige une factory qui préserve l'identité. À l'exécution, il
refuse aussi un pipeline dont les jetons n'ont pas de grammaire délimitée, comme un
masque (UnrecognizableFactoryError). Cette grammaire lui permet de
reconnaître les jetons que le modèle invente (InventedPlaceholderStrategy).
Après la restauration, tout jeton qui suit encore la grammaire des placeholders n'a
pas été émis par le pipeline. Le détail des stratégies d'outil est dans
Stratégies d'appel outil.
L'observation
piighost émet une trace par étape du pipeline à travers un port
(AnyObservationTracer), une couture au-dessus d'OpenTelemetry. Sans backend configuré,
une implémentation no-op ne trace rien et ne coûte rien. Le pipeline peut donc toujours
émettre ses traces sans vérifier si le traçage est actif. Un observation_redactor optionnel
remplace les valeurs des traces par des jetons, pour un backend qui n'a pas le droit de
voir les données confidentielles.
La config, point de composition
Un fichier TOML ou JSON décrit tout le pipeline. Le sous-système config le lit avec
pydantic-settings et le convertit en modèles de config. Ces modèles sont des unions
discriminées, où chaque type de composant porte une méthode build(). Assembler le pipeline revient à
appeler build() sur chaque modèle.
from piighost.config import load_pipeline, load_thread_pipeline

pipeline = load_pipeline("pipeline.toml")
thread_pipeline = load_thread_pipeline("thread.toml")
Un fichier sans section [memory] construit un pipeline. Un fichier qui déclare une section [memory] construit un pipeline de conversation. Chaque chargeur refuse le fichier destiné à l'autre. load_pipeline refuse un fichier avec [memory], et load_thread_pipeline un fichier sans.
Le couplage est à sens unique. La config dépend du coeur et des adaptateurs, mais le
coeur n'importe jamais la config. Ajouter un composant, c'est écrire un adaptateur, un modèle
de config avec build(), et rien d'autre. Le pipeline ne change pas.
Modèles de données
Tous les modèles du coeur sont des dataclasses gelées, immuables donc partageables entre coroutines sans risque.
| Modèle | Champs clés |
|---|---|
Detection | text, label, span: Span, confidence |
Entity | detections: tuple[Detection, ...], label et text en propriété |
Span | start, end, overlaps(), extract() |
Voir aussi
- Conception du pipeline : pourquoi chaque étape existe et dans quel ordre.
- Fabriques de placeholders : les familles de jetons et ce qu'elles préservent.
- Stratégies d'appel outil : le détail de
awrap_tool_call. - Étendre piighost : brancher son propre adaptateur derrière un port.
- Référence des modèles de données : les champs, méthodes et validations de
Detection,Entity,SpanetChunk.